Présentation du Cours
Objectif du cours
Initier l’étudiant à la collaboration en équipe de développement d’applications et à la méthodologie de développement.
Fait suite au cours portant sur le développement d’objets intelligents et prépare l’étudiant au projet intégrateur
Les 4 choses à apprendre...
git: sans git notre vie est tristeIntroduction à la conception d’applications : parce qu'il faut
Méthode Agile: Pour être trendy
Conception générale et détaillée: Parce que nous aimons le code.
Lien principal
Présentation de l'Enseignant
didier amyot
Étudié en mathématiques
Programmeur avant toutes choses
Python
Java
Clojure
Go
Rust
JavaScript/TypeScript
Travaillé à trop de places.
$4^{ime}$ cours que j'enseigne
Présentation des Étudiants
Étudiants
- Votre nom
- Vous étudiez en quoi
- Vous aimez quoi
- Language de programmation préféré
Présentation des Objectifs Du Cours
Détails
Pondération
1-2-2Comment me contacter (didier.amyot@collegeahuntsic.qc.ca)
Horaires - mercredi & vendredi de 13h00 à 16h00
Présence en classe
Évaluations
Plagiat (ChatGPT)
Mise-en-place (aka setup)
Créer un compte github
Ajouter les alias commun..
▶ git config --global alias.co checkout
▶ git config --global alias.br branch
▶ git config --global alias.ci commit
▶ git config --global alias.st status
Vérification.
▶ git config --list
alias.ass=add
alias.br=branch
alias.co=checkout
alias.st=status
include.path=/nix/store/471bf9jb0fkh15n8kcjbfsnnak5njp14-hm_gitconfig
color.ui=auto
core.autocrlf=input
core.editor=vi
core.quotepath=false
gui.editor=kate
init.defaultbranch=main
pull.default=current
push.default=current
user.email=didier.amyot@gmail.com
user.name=didier amyot
Ajouter la clé publique ssh à github!
C'est quoi git?
Selon le site web officiel
Git is a free and open source distributed version control system designed to handle everything
from small to very large projects with speed and efficiency.
Git is easy to learn and has a tiny footprint with lightning fast performance. It outclasses SCM
tools like Subversion, CVS, Perforce, and ClearCase with features like cheap local branching, convenient staging areas, and multiple workflows.
Selon wikipedia (anglais)
Git (/ɡɪt/)[8] is a distributed version control system that tracks changes in any set of computer files, usually used for coordinating work among programmers who are collaboratively developing source code during software development. Its goals include speed, data integrity, and support for distributed, non-linear workflows (thousands of parallel branches running on different computers)
Logiciel de gestion de versions - wikipedia
Un logiciel de gestion de versions (ou VCS en anglais, pour version control system) est un logiciel qui permet de stocker un ensemble de fichiers en conservant la chronologie de toutes les modifications qui ont été effectuées dessus. Il permet notamment de retrouver les différentes versions d'un lot de fichiers connexes.
Objectif
Savoir qui à changé le code source
Savoir quand le code source à changé
savoir pourquoi le code source à changé
Objectif (autre point de vue)
Travailler ensemble
Garder l'historique du projet
Le monde sans Git
Travailler en équipe
partage le code par courriel ou dropbox
l'historique du projet est gardé dans des fichier zip un peu partout
Reconcilliation du travaille
- Toute une équipe s'assoit à une table a café en fumant des cigarettes pour "merger le code"
Git - l'idée géniale
On va travailler localement!
Toute l'historique du projet sera gardé dans le projet. Un projet sous système de version se nomme un "répository"
On utilisera un outil en ligne de commande
gitpourajouter à l'historique
chercher dans l'historique
merger le répository locale avec d'autres répositories
Un projet git typique
projet-koala/
├─ .gitignore
├─ .git/
├─ src/
│  ├─ server.ts
├─ README.md
Mais nous ne sommes pas de anarchistes!
origin
On utilisera Github comme origin
Github deviendra le "source of all thruth" pour ce qui est dans le projet
Github deviendra la vitrine publique de notre projet
Chaque contributeur "pushera" ces changements sur github
Chaque contributeur "pullera" les changements des autres de github
Workflow
flowchart TD
    A[github]-- Pull/Push ---X[Manel]
    A[github]-- Pull/Push ---Y[Walid]
    A[github]-- Pull/Push ---Z[Haikel]
    A[github]-.- |Pull| U[didier]
Sur Github
On peut créer des "issues"
On peut rouler les unit tests automatiquement.
On peut même déployer automatiquement
CI/CD
continuous integration (CI) and continuous delivery
flowchart LR
    A[Programmeur]-.-> B["Github"]
    B-- GitHub\nActions -->C["Builder"]
    C-- GitHub\nActions --> D["Tester"]
    D-- GitHub\nActions --> E["Deployer"]
Git - Terminologie
Répository
Un dossier managé par git
Le dossier contient un sous dossier
.gitqui contient tout l'historique
Remote
Une source du code dans un lieu fort fort lointain (ex: github, gitlab)
d'habitude, il y a un seul remote qui se nomme
origin
Commit
Un snapshot complet de tout le répo à un certain temps
Est identifié avec un hash
Contient le hash des parents
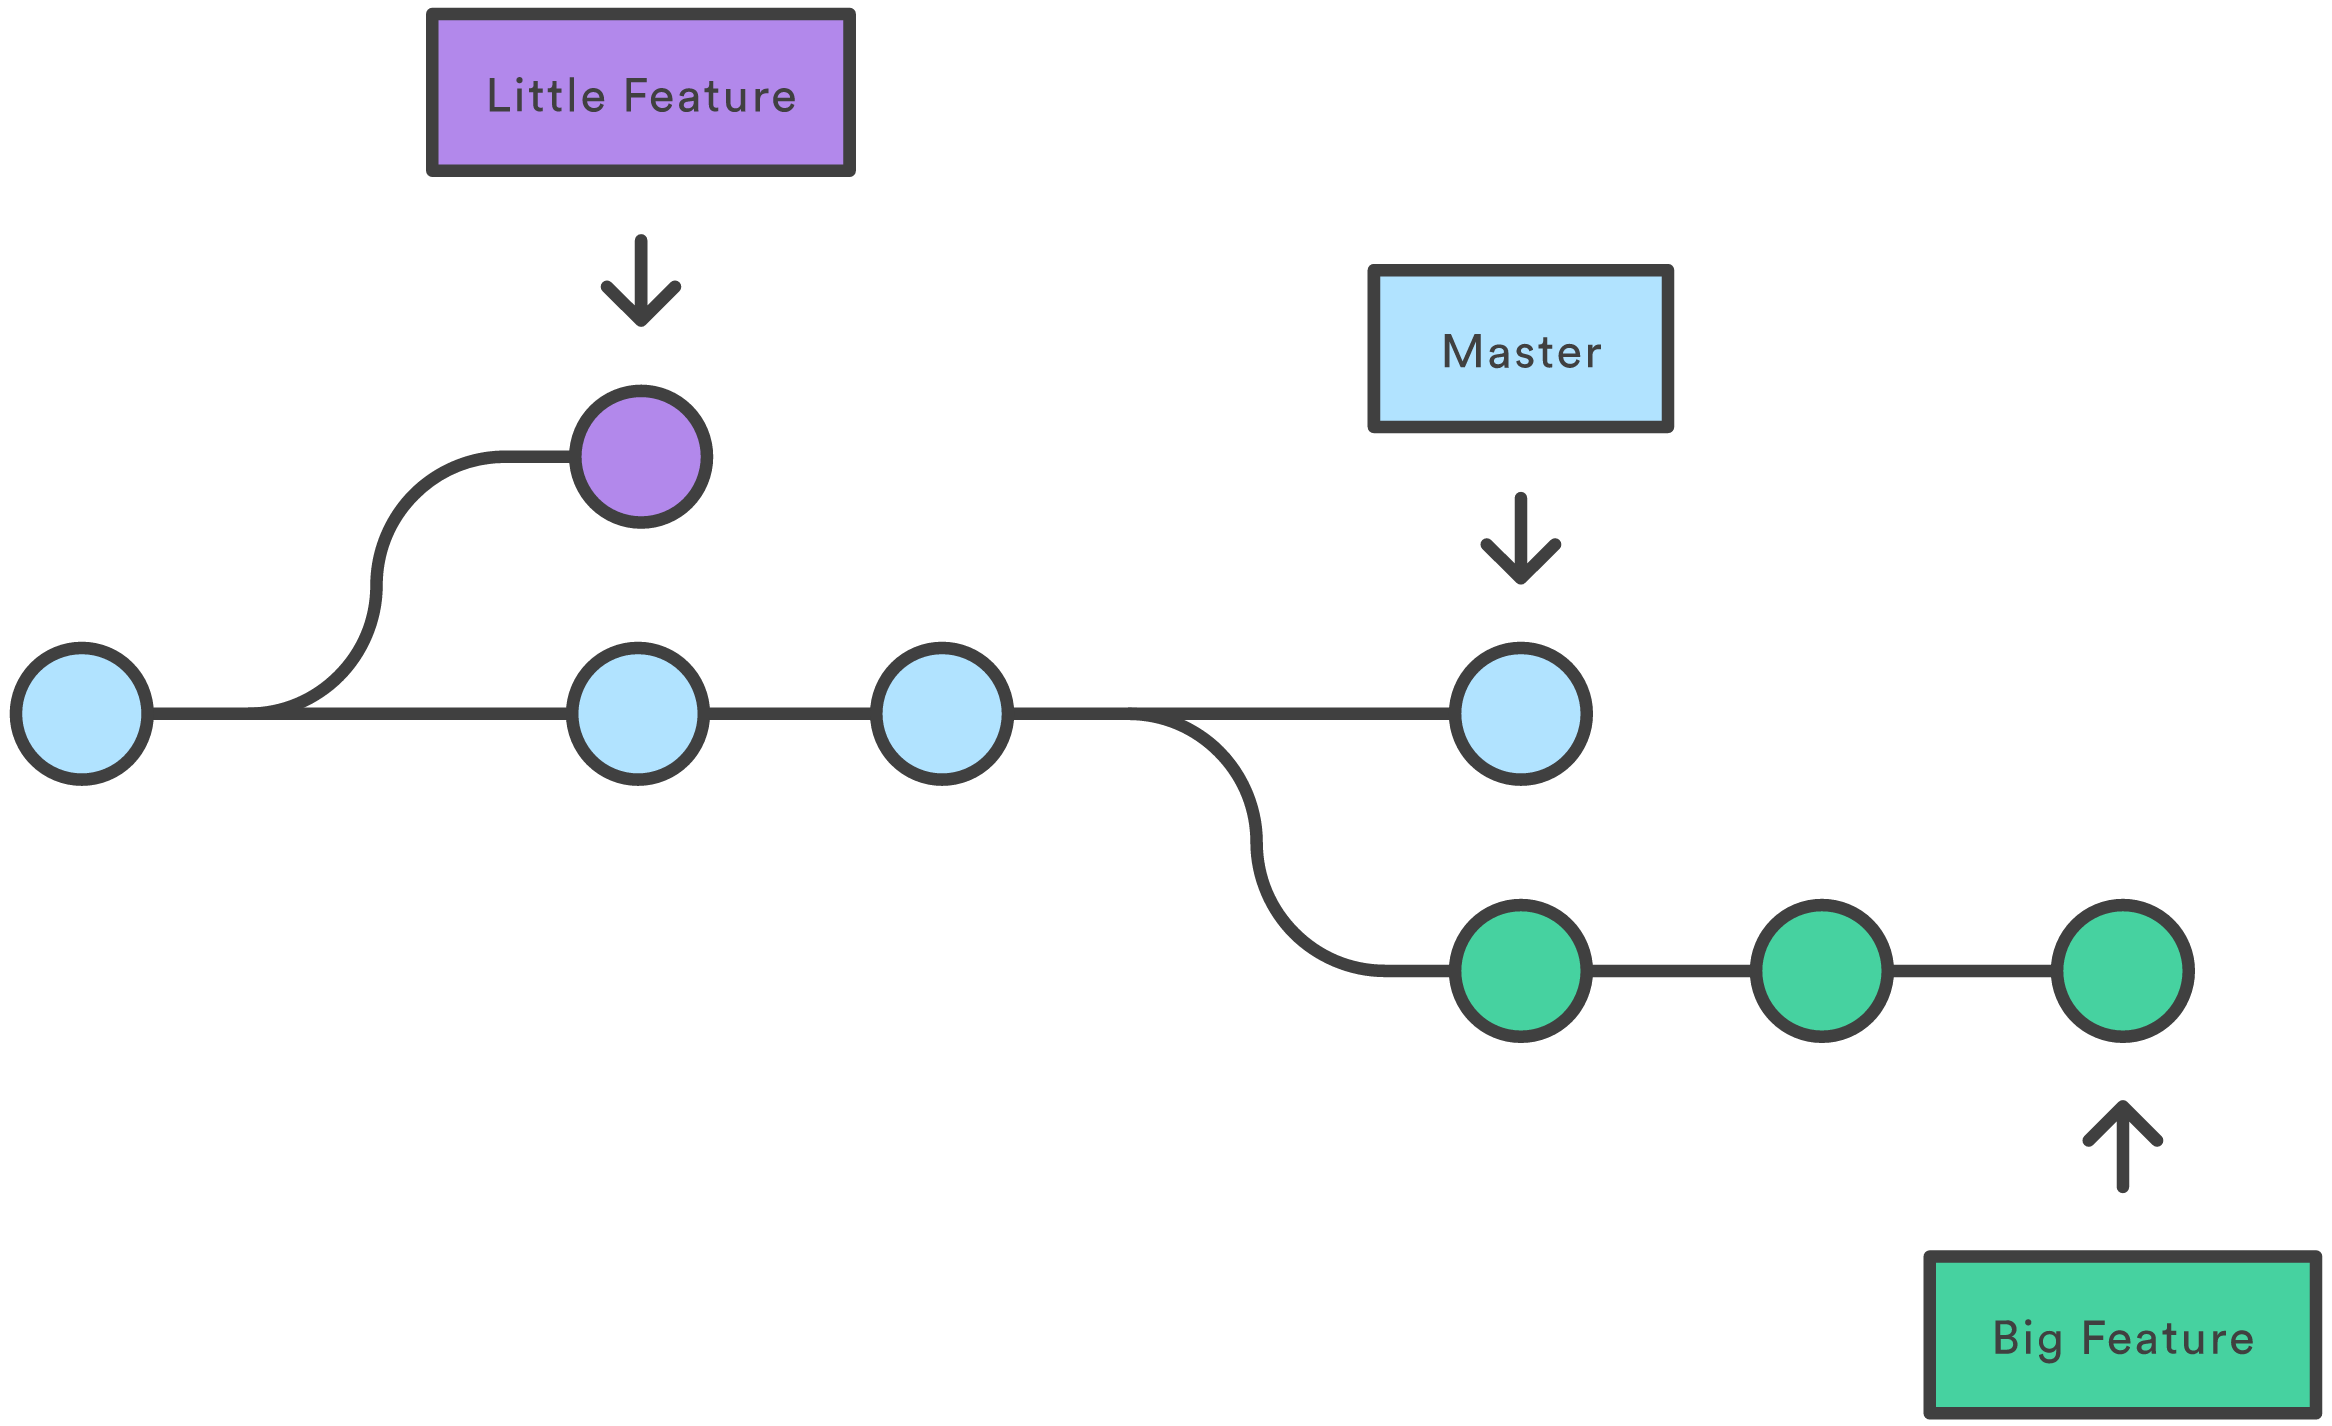
Branch
On peut travailler sur plusieurs features en parallel sur le même projet.
Une branch est un peu comme le commit le plus récent
La branche principale se somme usuellement
mainoumaster
HEAD
Mot que git utilise pour dire "la branche courrante"
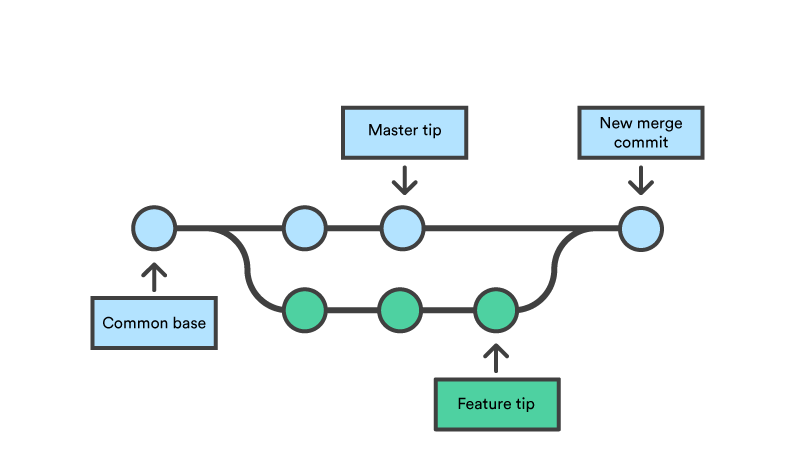
Merge
Former un nouveau commit à partir de plusieurs commit
La pluspart du temps, on merge un branche dans une autre branch
Git - Les commandes git de base
git clone <url>
Sert à cloner une projet.
Ça prend une copie complète d'un projet avec tout l'historique
On fait des changements
Parce que nous aimons cela!
Parce que c'est nécessaire
git status (git st)
On regarde l'état du répo local
On voit tous les changements
On peut utiliser
git diffpour regarder les changements avec
git add <...files>
Les changements que nous voulons sauvegarder
Ici, nous ne "committons" pas encore les changements
Nous dissons, "Je pense que je devrait sauvegarder cela"
Les changements ajoutés sont dans le "staging area"
git commit -m "<Le message du commit>"
Là nous demandons à git de sauvegarder nos changements
Tous les changements "stagés"
git push
on upload nos changements sur un remote
on peut uploader nos sur une autre branche ou un autre remote avec
git push <remote-name> <branch-name>(git push origin master)
Branches
C'est quoi une branche?
On peut travailler sur plusieurs features en parallel sur le même projet.
Une branch est un peu comme le commit le plus récent
La branche principale se somme usuellement
mainoumaster
Git status
git statusmet en évidence la branche sur laquel nous nous trouveons
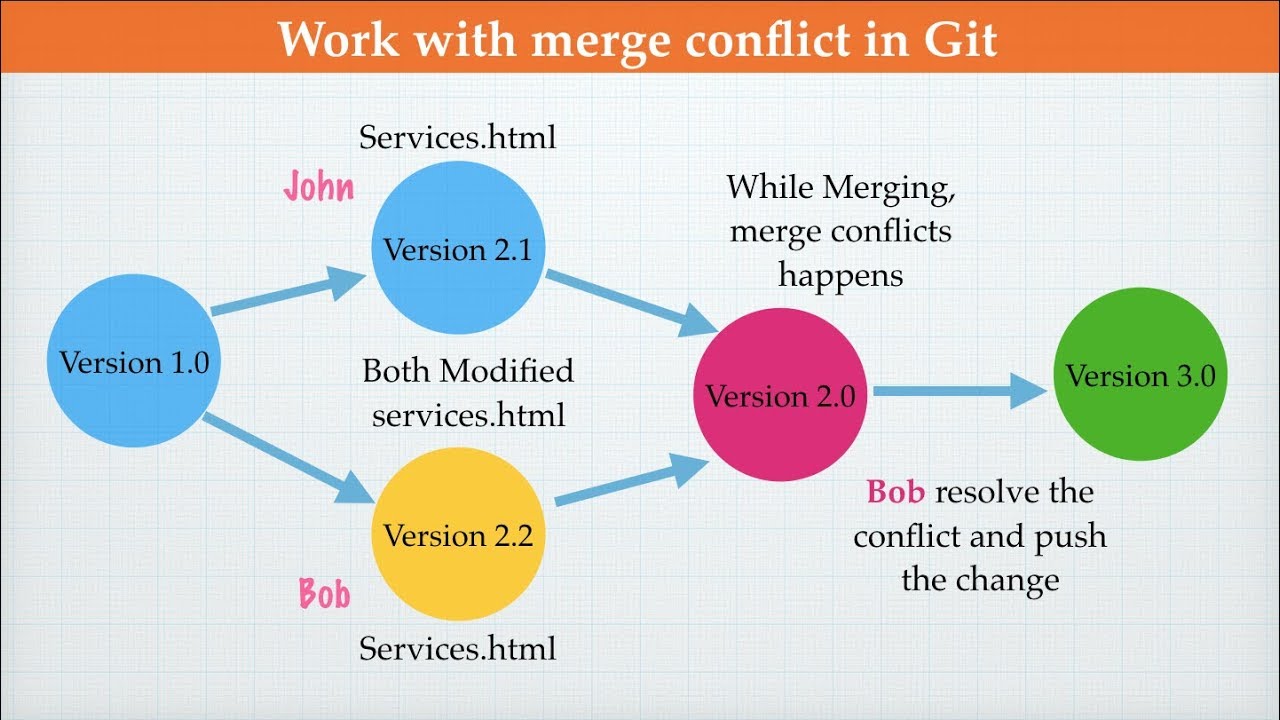
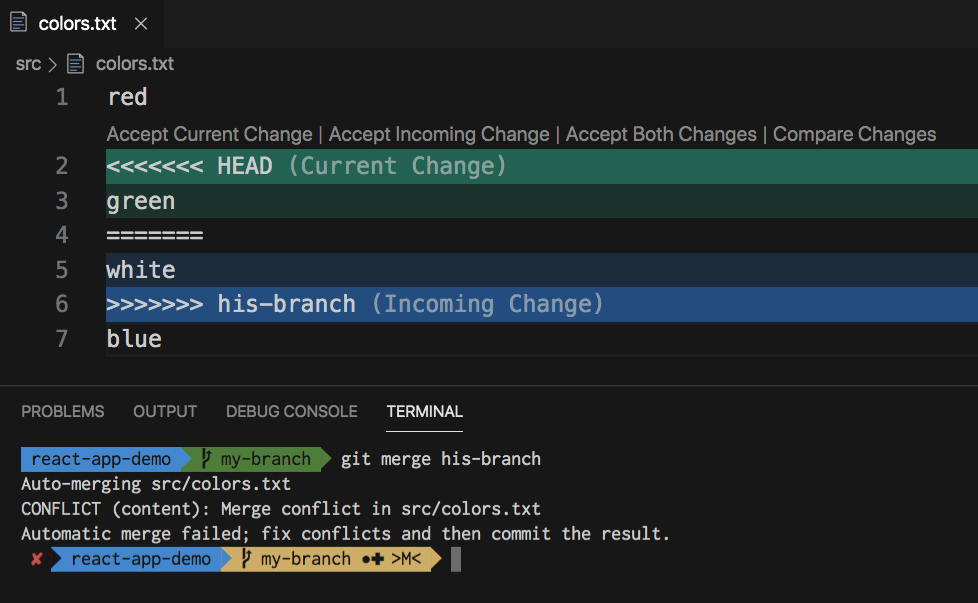
Merge conflicts
Lors d'un merge, si deux branches changent la même section
Il y a une "merge conflict"
C'est à vous de résoudre le conflit
Notes importants
Ce cours est un plagit du cours donnés par Anastasiya Basanets
Anastasiya.Basanets@collegeahuntsic.qc.ca
Le development d'application c'est n'importe quoi
Il y a une excellente source pour mettre de l'ordre dans ce tas de kakashka: https://neverworkintheory.org/
Cours
À quoi sert les différentes méthodes?
Beaucoup de types différents de logiciels :
- Logiciel de base (système d'exploitation, pilotes)
- Applications traditionnelles et web
- Jeux vidéos
- Logiciel scientifique et de recherche
- Logiciel embarqué (sur circuit électronique)
- Modules d'intelligence artificielle
- Etc
Chaque logiciel est développé en utilisant une approche différente, qui demande réflexion!
Exemples
On ne programme pas de la même manière un jeu vidéo et un électrocardiogramme.
Jeux video
Livraison: Pression du marché (ex.: sortir pour Noel, pour une plateforme, pour devancer la compétition).
Impact d'un bogue: On fera un correctif (« patch »).
électrocardiogramme
Livraison: Préférable d’être en retard que de livrer un produit dangereux.
Impact d'un bogue: Dommages aux personnes
Exemples
On ne programme pas de la même manière un jeu vidéo et un électrocardiogramme.
Firefox version 1
Priorités du développement: Découvrir les besoins des clients, trouver des solutions, implémenter, et valider que cela correspond aux besoins, etc.
Firefox version 57
Priorités de la maintenance: Corriger les bogues, fermer les failles de sécurité, identifier des besoins émergents, assurer que l'architecture reste saine, etc.
À quoi sert les différentes méthodes?
Ainsi, dans un projet typique, entre 60% et 80% de l’effort consacré au logiciel a lieu après la livraison, soit avec la correction des bogues et la maintenance.
Le développement doit donc produire un logiciel maintenable, en plus de 4 défis majeurs.
Étapes de développement
| Discipline | Exemple d’activités |
|---|---|
| Exigences | Définition du problème Définition des exigences (spécifications) |
| Conception | Conception architecturale Conception détaillée |
| Implémentation | Codage et débogage Tests unitaires Intégration et tests d’intégration |
| Tests | Tests boîtes blanche (vérification) Tests boîte noire (validation) |
| Déploiement | Période de rodage (ajustement post-livraison) Maintenance corrective (correction bogues) Maintenance perfective (ajout de fonctionnalités) |
Cycle de development
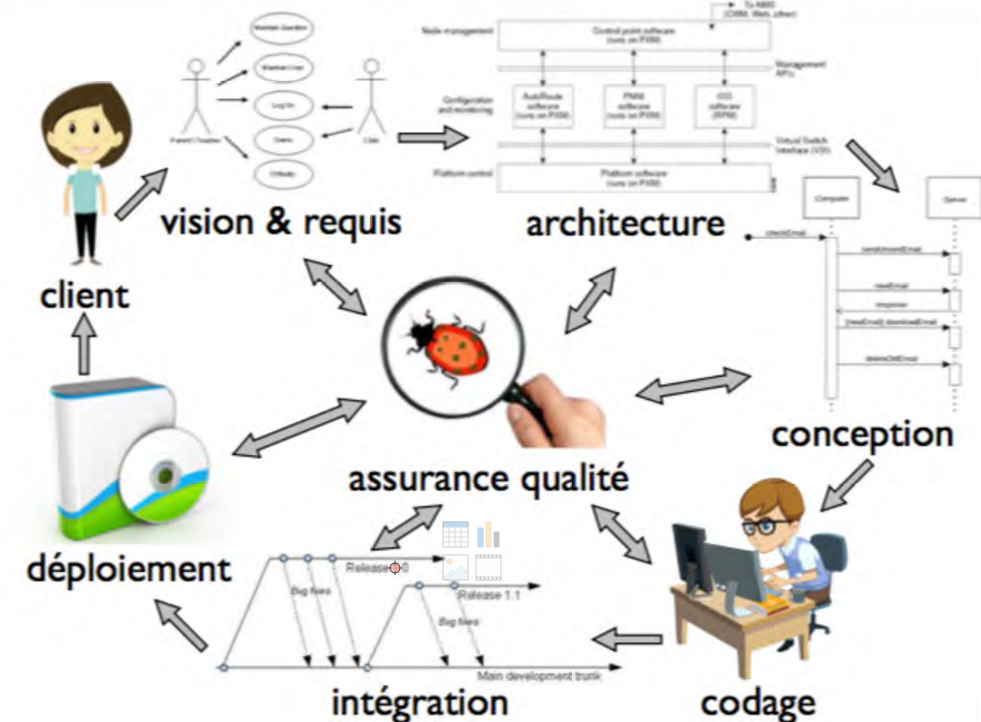
Question 1
Pourquoi est-il important de penser à la maintenance du logiciel avant de commencer le développement ?
- Parce que la maintenance est la première étape du développement logiciel.
- Parce que la majorité du coût du logiciel provient de l'effort effectué durant la maintenance.
- Parce que la maintenance est l'étape où le code est écrit.
- Parce que nos logiciels sont toujours pleins de bogues et qu'il faut prévoir beaucoup de temps pour les corriger.
Question 2
Un logiciel n'est pas comme un bâtiment : il ne peut pas s'effondrer et tuer une personne. En conséquence, il est normal que les logiciels soient moins stables que les bâtiments
Vrai
Faux
Cycle de vie et cas d’utilisation
Terminologie
Processus de développement logiciel: Ensemble d'activités, de documents et des compétences nécessaires pour la réalisation d'un produit. Approche adaptée au contexte.
Cycle de vie: Vue de très haut niveau décrivant l'ordre dans lequel les disciplines sont effectuées.
Activités: Élément de travail. Décrit les tâches qui réalisent les artéfacts.
Artéfacts: Élément d’information. Généralement un document, mais peut être un courriel, ou même un échange verbal.
Rôle: Décrit les compétences requises pour faire une activité. Les responsables assignées à un rôle sont responsables des artéfacts produit par l’activité.
Cycles de vie: Cascade
Faisable si toutes les informations requises sont disponibles au début du projet.
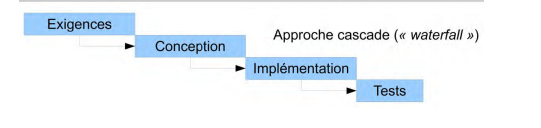
Avantages:
- Gestion facile
- Toutes les tâches se planifient
- Points de contrôle précis permettant de décider si l’on va de l’avant (go/no go)
Cycles de vie: Cascade
Cascade peut être approprié lorsque:
- Faible incertitude au niveau des besoins du clients
- Faible incertitude technique
- Réalisation répétitive
- Peu d’aspects novateurs
- Faible participation du client/utilisateurs
- Pas d’urgence de voir le produit fini
*** Un changement mineur peut avoir des répercussions à travers tout le projet.
Cycles de vie: Cascade (V, W ou X)
V : Activités de développement.
W, X : Ajout des activités d'assurance-qualité.
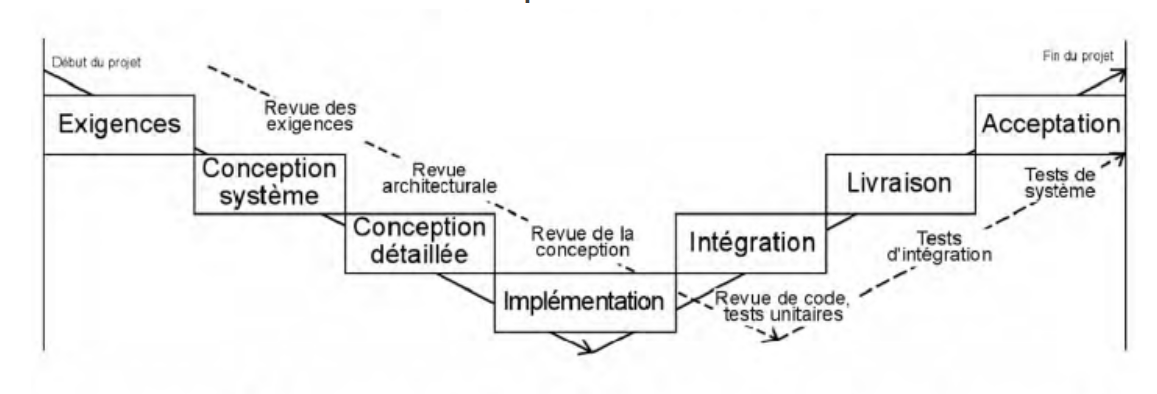
- Approche essentiellement en cascade avec des revues et des inspections.
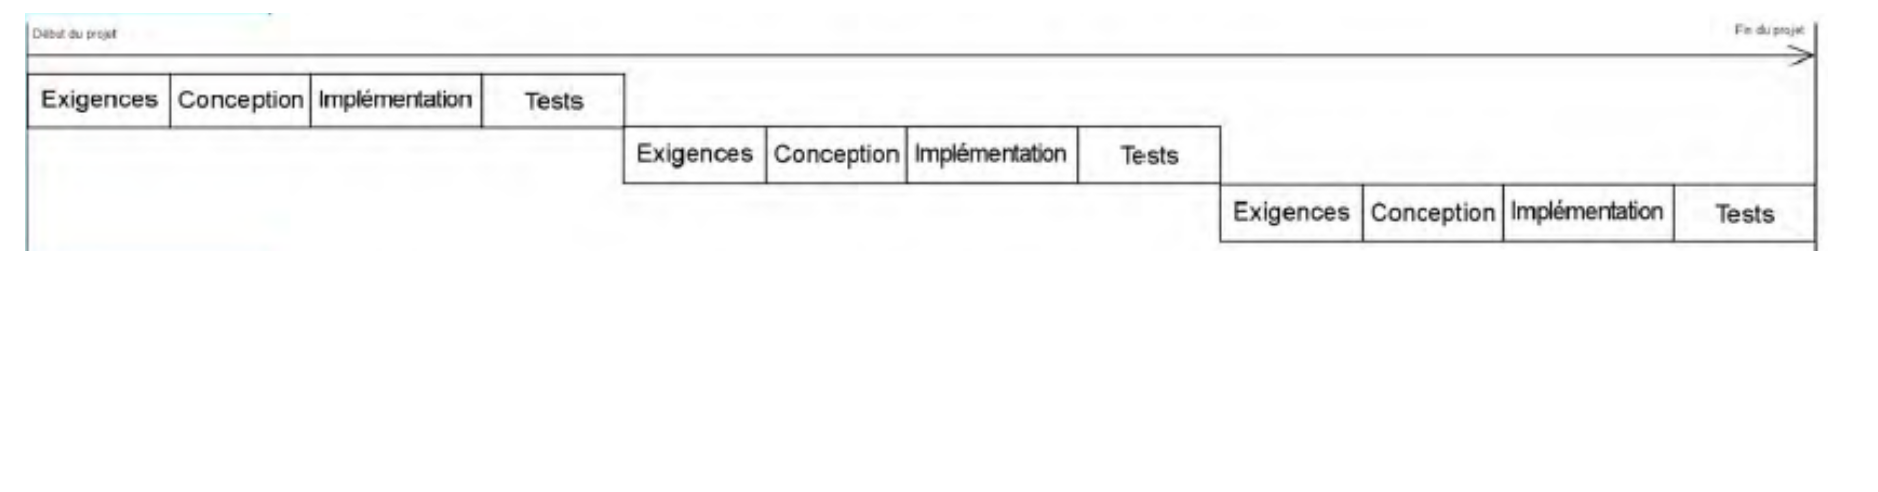
Cycles de vie: Incrémental (itératif/évolutif)
Itérations (cycles rapides) de production d’un produit fonctionnel. Les itérations sont indépendantes les unes des autres. Généralement, une itération dure entre 2 à 6 semaines. Une portion des exigences est connue au préalable.
Cycles de vie: Incrémental (itératif/évolutif)
Avantages
- Génère du code fonctionnel rapidement dès le début du projet
- Plus de flexibilité: plus facile de changer les exigences en cours de projet
- Gestion du risque plus facile: une itération permet de passer à travers toutes les étapes du développement et d’identifier les problèmes.
- Chaque itération est une petite approche cascade facile à gérer.
Désavantages
- Des problèmes d’architecture peuvent survenir parce que les exigences ne sont pas toutes claires au départ.
- Difficile de déterminer la fin du projet.
- Difficile d’estimer adéquatement les tâches pour finir l’itération du temps.
Importance des exigences
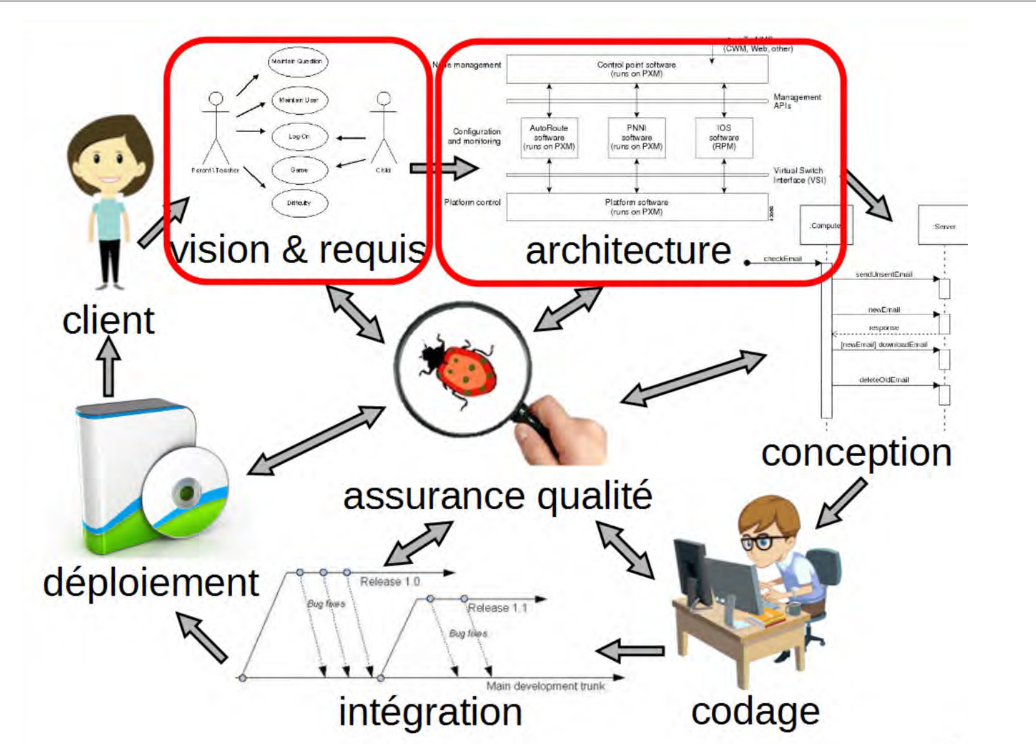
À quoi servent les exigences?
Servent à définir le travail à faire : budget, échéancier, contrat avec les clients.
Servent de base a la conception: document d'architecture permettant la création du code.
Servent à définir les tests d'acceptation.
À quoi servent les exigences?
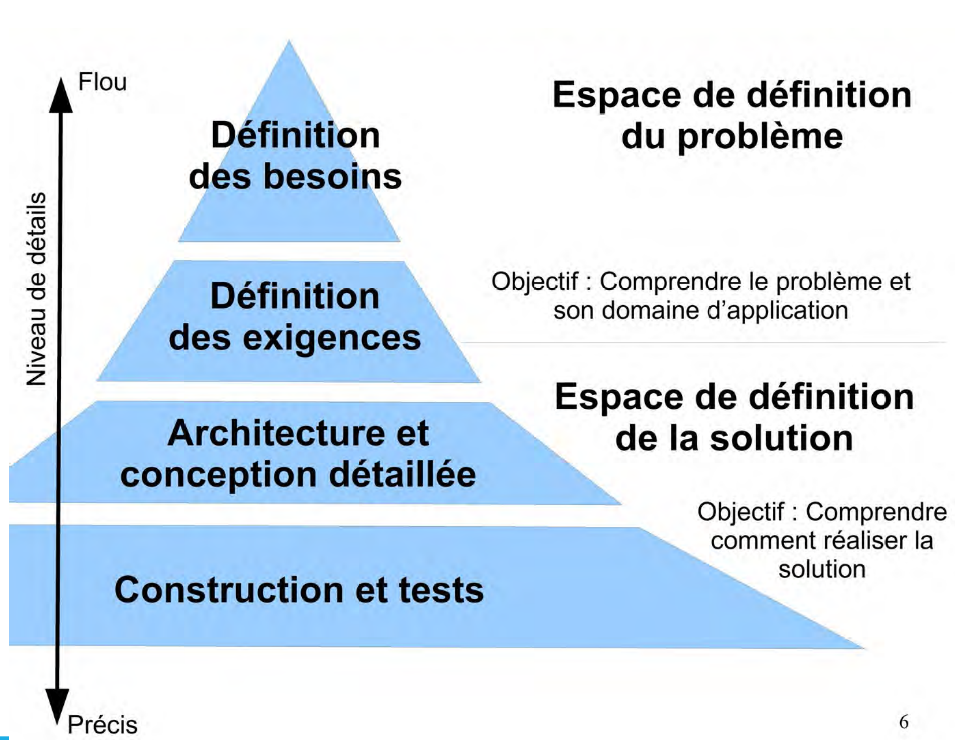
Document de vision
Une simple formulation du problème sur quelques pages. Problème décrit du point de vue des utilisateurs (décrit leurs besoins).
Besoin ≠ Exigence
- Besoin est de haut niveau et flou Ex: Le système sera facile à utiliser.
- Exigence est de plus bas niveau et plus formel
- Ex: Chaque fonctionnalité du système doit avoir une info-bulle.
Les projets sont en retard à cause des exigences
- Requirements redinement
- Task dependencies
- Organizational alignment
- Organixational politics
- Geographic distribution
n.b.: "technical problems" ne fait meme pas parti du top 5
Méthodes pour avoir les Exigence: Building A Plane While Flying (addition par didier)
ide
construire le plus rapidement possible
Évite de construire des choses innnutile
Force d'avoir un produit rapidement
Sources
https://medium.com/@coachjennie/the-freedom-of-building-the-plane-while-flying-it-96dd2d899656
Pis 1 000 000 de résultats sur google
https://neverworkintheory.org/
Markdown & Diagrams
Markdown - Historique
Définition
Markdown is a lightweight markup language for creating formatted text using a plain-text editor. John Gruber created Markdown in 2004 as a markup language that is easier to read in its source code form. Markdown is widely used for blogging and instant messaging, and also used elsewhere in online forums, collaborative software, documentation pages, and readme files.
-- wikipedia
Objectif du markdown
Écrire de la documentation
Façile à écrire
Façile à lire directement
Façile à convertir en HTML
Le markdown est utilisé partout!
github (gitlab) présente les fichiers avec une extension
.mdcomme markdownslack
Intégration avec tous les IDE
Jira
jupyter (ces notes de cours)
hugo (mon blogue)
GitHub Flavored Markdown
La version du markdown que nous utilisons usuellement
Extension de markdown pour ajouter des fonctionnalités non présentes dans la première version
Retrait de fonctionnalités insécures
Tous vos répo github devraient avoir un README.md
Écrit en markdown
Qui explique le projet
Où pratiquer sont markdown
Utilisons gist!
Recette
logger-in dans github
aller sur https://gist.github.com/
Choisir un nom de fichier qui fini par
.mdcliquer sur "Preview" pour pré visualiser votre résultat
Markdown
Markdown (titres)
# Gros title

Lorem ipsum dolor sit amet, consectetur adipiscing elit

## Title

sed do eiusmod tempor incididunt ut labore et dolore magna aliqua. Ut enim ad minim veniam, quis nostrud exercitation

### Petit title
Excepteur sint occaecat cupidatat non proident, sunt in culpa qui officia deserunt mollit anim id est laborum.
HTML
Gros title
Lorem ipsum dolor sit amet, consectetur adipiscing elit
Title
sed do eiusmod tempor incididunt ut labore et dolore magna aliqua. Ut enim ad minim veniam, quis nostrud exercitation
Petit title
Excepteur sint occaecat cupidatat non proident, sunt in culpa qui officia deserunt mollit anim id est laborum.
Markdown (tableaux)
https://www.tablesgenerator.com/markdown_tables
| Tables   |      Are      | Cool |
|:---------|:-------------:|-----:|
| col 1 is |  left-aligned | 1600 |
| col 2 is |    centered   |   12 |
| col 3 is | right-aligned |    1 |
HTML
| Tables | Are | Cool |
|---|---|---|
| col 1 is | left-aligned | 1600 |
| col 2 is | centered | 12 |
| col 3 is | right-aligned | 1 |
Markdown (code block)
Ceci est un code block

```python
def append(lst, x):
    return lambda ishead : x if ishead else lst
```

```js
function cons(lst,x){
    return function (isHead){
        return isHead ? x : lst;
    }
}
```
HTML
Ceci est un code block
def append(lst, x):
    return lambda ishead : x if ishead else lst
function cons(lst,x){
    return function (isHead){
        return isHead ? x : lst;
    }
}
Documentation
Mermaid
C'est quoi?
- Un language pour faire beaux diagrams
- Qui est rendu vraiment populaire comme extension avec le markdown
- Facile à utiliser dans le html
---
title: Example Git diagram
---
sequenceDiagram
    Alice->>John: Hello John, how are you?
    John-->>Alice: Great!
    Alice-)John: See you later!
La manière de travailler avec mermaid
prendre un exemple pas trop loin de ce que nous voulons https://mermaid.js.org/syntax/flowchart.html
modifier l'exemple dans l'éditeur https://mermaid.live/edit
Diagrammes UML
L'UML est le langage de modélisation standard le plus utilisé. Il définit 13/14 modèles (vues) différents basés sur une apparence (look-and-feel) similaire.
Diagramme de cas d’utilisation (use case diagram): Permet de modéliser les actions/fonctionnalités faites par un acteur (utilisateur) avec un futur logiciel.
Diagramme de séquence: Diagramme d'interaction qui met l'accent sur la chronologie de l'envoi des messages. Normalement, chaque cas d'utilisation détaillé a un diagramme de séquence. Le diagramme de séquence aide a faire le lien entre le cas d'utilisation (haut niveau) et le diagramme de classe (bas niveau).

Nous, nous verrons deux type de diagrams
Use Case Diagrams
Sequence Diagrams
Use Case Diagram
Tout ce cours est un plagit flagrant d'un vidéo de 12 minutes
C'est quoi un "use case"?
Un cas d'utilisation, bloc fonctionnel ou cas d'usage (« use-case » en anglais), définit en génie logiciel et en ingénierie des systèmes une manière d'utiliser un système qui a une valeur ou une utilité pour les acteurs impliqués
Le cas d'utilisation correspond à un ensemble d'actions réalisées par le système en interaction avec les acteurs en vue d'une finalité.
L'ensemble des cas d'utilisation permet ainsi de décrire les exigences fonctionnelles d'un système en adoptant le point de vue et le langage de l'utilisateur final.
-- wikipedia
Cas d’utilisation (use case)
Objectifs des cas d’utilisation:
- Capturer le comportement désiré du système
- Spécifier ce que le système fait (fonctions), mais pas comment il le fait.
- Servir d’entente entre les développeurs, les utilisateurs et les experts sur les fonctions disponibles et sur la façon d’interagir avec le système.
- Servir à valider l’architecture logicielle qui sera développée.
Un cas d’utilisation est un document narratif qui décrit la séquence d’évènements dans laquelle un acteur (un agent externe) utilise un système pour accomplir un processus.
Cas d’utilisation (use case)
Les cas d’utilisation peuvent être spécifiés avec différents niveaux de détail:
Format de haut niveau
- Abrégé, peu détaillé
- Décrit le scénario principal seulement
Format informel
- Court
- Brève description des scénarios alternatifs
Format étendu:
- Très détaillé
- Description complète du scénario principal et des scénarios alternatifs
Cas d’utilisation de haut niveau
Un exemple de cas d’utilisation pour le guichet automatique:
| Use case | Effectuer un retrait |
| Acteur(s) | Client |
| Type | Primaire |
| Description | Un client se présente au guichet automatique, s'identifie, retire un montant d'argent et quitte avec son argent |
Use Case Diagram
Objectif: montré plusieurs "use case" sur le même diagram
Montrer comment le système interagit avec des "agents exterieurs"
Montrer les actions importantes
Montrer les relations entre les actions
Montrer les relations entre les acteurs et les actions
Briques
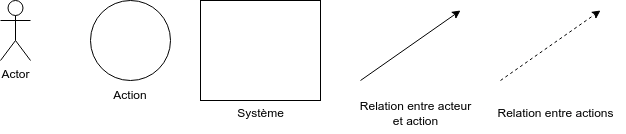
Use case diagram

Diagramme de cas d’utilisation (use case)
Après avoir identifié les requis du système, définir les frontières du système, puis identifier les acteurs et les cas d’utilisation.
Écrire tous les cas d’utilisation en format de haut niveau et les catégoriser comme primaires, secondaires ou optionnels.
Tracer un diagramme de cas d’utilisation (cas d’utilisation primaires).
Identifier et illustrer les relations entre les cas.
Écrire les cas d’utilisation les plus critiques, influents ou risqués dans un format étendu et essentiel.
Écrire le minimum de cas réels.
Ordonner les cas d’utilisation en ordre d’importance.
Diagramme de cas d’utilisation
Facile à comprendre par les utilisateurs et les développeurs.
Permet de faire un inventaire de haut niveau des exigences. Aide à détecter des exigences implicites ou oubliées.
Ce diagramme regroupe plusieurs cas d'utilisation (use cases) afin de donner une vue d'ensemble actions possibles.
Exemple pour faire un dessert...
- Faire dessert
- Faire Gateau
- Faire Glassage
Didier fait le gateau
Stephanie est la comme experte
À la base
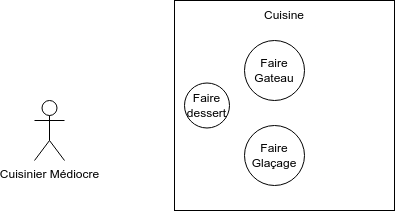
Acteurs:
- cuisinier médiocre
Systemes:
- Cuisine
Actions
- Faire Gateau
- Faire dessert
- faire glaçage
acteurs
Représente une "catégorie de personne" pas une personne
Peut être une personne physique, un système ou autre..
Les acteurs sont toujours extérieur au système
Acteurs principaux
- Initie l'intéraction avec le système
- Placé à gauche du diagram
Acteurs secondaires
- est réactif au système
- Placé à droite du diagram
Interations
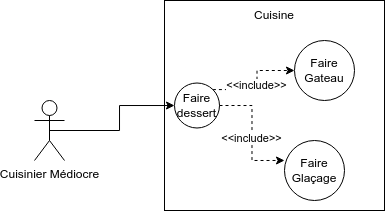
Interations Acteurs-Actions:
- Le cuisinier médiocre fait le dessert
Systemes:
- Cuisine
Interations Acteurs-Actions:
- Pour Faire Dessert il faut Faire Gateau
- Pour Faire Dessert il faut Faire Glacage
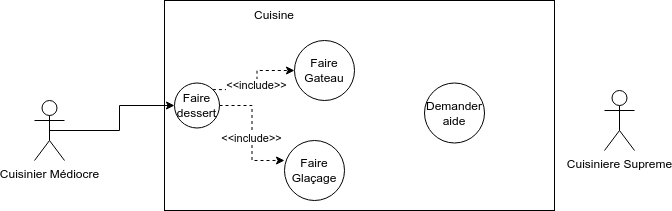
Interations
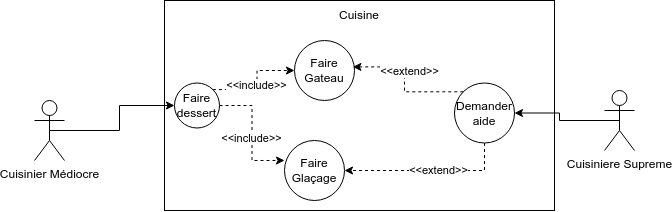
Interations Acteurs-Actions:
- Le cuisinier médiocre fait le dessert (principal)
- La cuisiniere supreme donne de l'aide (secondair)
Systemes:
- Cuisine
Interations Acteurs-Actions:
- Pour Faire Dessert il faut Faire Gateau
- Pour Faire Dessert il faut Faire Glacage
- Faire Gateau peut utiliser Demander aide
- Faire Glacage peut utiliser Demander aide
Exercices
À partir des exigences suivantes, faites-en un diagramme de cas d’utilisation.
- Le jeu doit permettre au joueur de créer une partie
- Le joueur qui crée une partie s'y join automatiquement
- Le joueur peut quitter la partie à laquelle il joue
- Chaque joueur peut avoir une liste d'amis conservée par le jeu
- Un joueur peut ajouter un ami de la liste d'amis
- Un joueur peut enlever un ami de la liste d'amis
- Le jeur doit permetter au joueur d'inviter des amis faisant partie de sa liste d'ami à participer à une partie à laquelle il joue
Sequence diagram
Tout ce cours est un plagit flagrant d'un vidéo de 9 minutes
Exemple

C'est quoi un sequence diagram
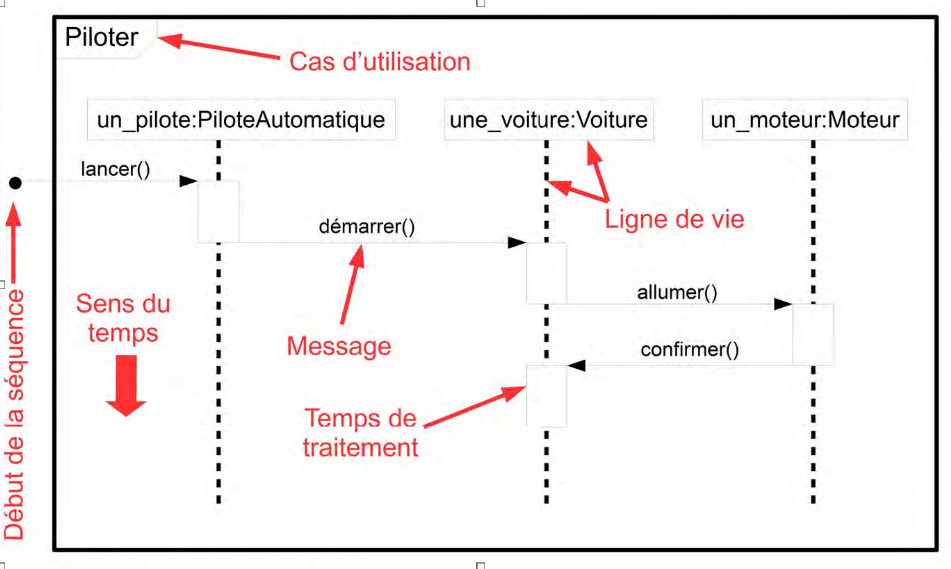
Les diagrammes de séquences sont la représentation graphique des interactions entre les acteurs et le système selon un ordre chronologique
Le diagramme de séquence permet de montrer les interactions d'objets dans le cadre d'un scénario d'un diagramme des cas d'utilisation
La dimension verticale du diagramme représente le temps, permettant de visualiser l'enchaînement des actions dans le temps, et de spécifier la naissance et la mort d'objets.
Différentes parties d'un diagram en séquence
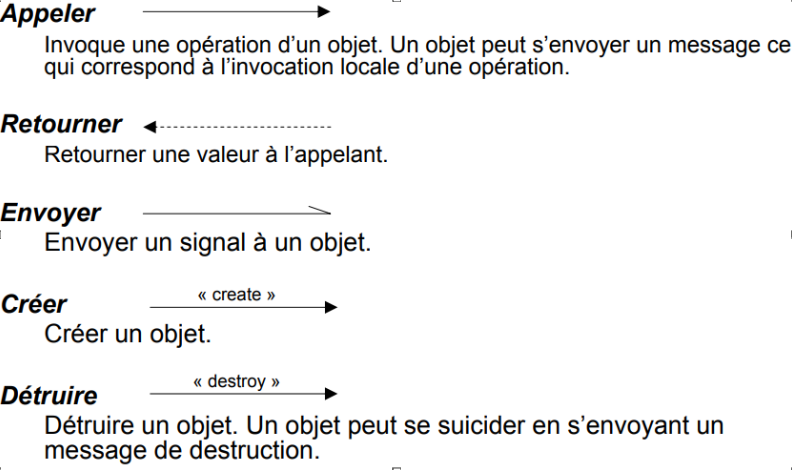
Flèches d'un diagram en séquence
Mermaid JS
- Mermaid est excellent pour les séquence diagrams
Agilité - expérience personel
Notes importante
- Tout ce qui suit est anecdotique
- Il s'agit de mon expérience personelle
- Désolé
Oubliez ça, j'ai des sources (ok, une)!
À quoi ressemble une compagnie?
Nombre de personnes
Entre 100 et 300 personnes
Surtout Business-to-business (B2B) vs Business-to-consumer (B2C)
Compagnie plus ou moins distribué
Environ 50% de la compagnie en "tech"
En 50% de la tech des programmeurs
Exemples
YouGov, firme de sondage
Behavox, logiciels pour banques
SquarePoint Capital, hedge found
Ivado Labs, consultation data science
Compagnie typique
flowchart TD
    C[Executif] --> T[Tech]
    C --> V[Vente]
    C --> F[Finance]
    C --> CS[Customer success]
Division de la tech
flowchart TD
    T[Tech] --> P1[Produit 1]
    T[Tech] --> P2[Produit 2]
    T[Tech] --> P3[Produit 3]
    T[Tech] --> Infra[Infrastructure]
Pression sur la tech
flowchart TD
    C[Executif] --> T[Tech]
    C --> V[Vente]
    C --> F[Finance]
    C --> CS[Customer success]
    V -.-> T
    CS -.-> T
    C -.-> T
    T -.-> T
Qui veut quoi?
Ventes
- De nouvelles fonctionnalités pour les nouveaux clients
- De nouvelles fonctionnalités pour des clients potentiels
Customer success
- Réparer les bugs pour les clients existent
- être certain que tout fonctionne tout le temps
- Nouvelles fonctionnalités pour clients existant
Executif
- Changer la direction de la compagnie
Tech
- Réparer les bugs
- Faire la maintenance
- Payer la debt technique
Scrum team
Équipe scrum
L’unité fondamentale de Scrum est une petite équipe, la Scrum Team. La Scrum Team se compose d'un
Scrum Master, d'un Product Owner et de Developers. Il n’y a pas d’équipe dans l’équipe ni de hiérarchies. Il s'agit d’une seule et même unité stable, composée de professionnels focalisés sur un seul objectif à la fois, l'Objectif de Produit.
-- https://scrumguides.org/docs/scrumguide/v2020/2020-Scrum-Guide-French.pdf
Équipe scrum par mon expérience
Équipe pluridisciplinaire (front-end developper, back-end, qa, data scientist)
Équipe autonomne
Petite, jamais en plus de 12 personnes
Équipe qui à une seule mission (e.g.: gérer mio)
Personnes dans un scrum team
- Developers
Les Developers sont les membres de la Scrum Team qui s'engagent à traiter tout ou partie utile d’un Increment à chaque Sprint.
- Product Owner
Le Product Owner est redevable de maximiser la valeur du produit résultant du travail de la Scrum Team.
- Scrum Master
Le Scrum Master est redevable de la mise en place de Scrum tel que défini dans le Guide Scrum.
Valeurs Scrum
- Engagement
- focus
- ouverture
- respect
- courage
Événement Scrum Principal: Le Sprint
Sprint
Tout le travail se fait dans un "sprint"
L'équipe doit avoir un objectif prédéfinit
L'équipe doit compléter son travail
Block de temps de 2 semaines où le travail est prédéfini
Chaque tâche est définit dans un ticket ou jira
Sprint...
Durant le Sprint :
- Aucun changement n’est permis, qui pourrait remettre en cause l’Objectif de Sprint ;
- Les objectifs de qualité ne sont jamais revus à la baisse ;
- Le Product Backlog est affiné si nécessaire ; et
- Le périmètre peut être clarifié et renégocié avec le Product Owner selon ce qu'on en apprend.
-- scrum guide
En pratique..
- Un spring est une collection de tickets (jiras) qu'il faut faire
- Chaque ticket à une difficulté (en point)
- Le nombre total de points de l'équipe est la capacité de l'équipe
En pratiques
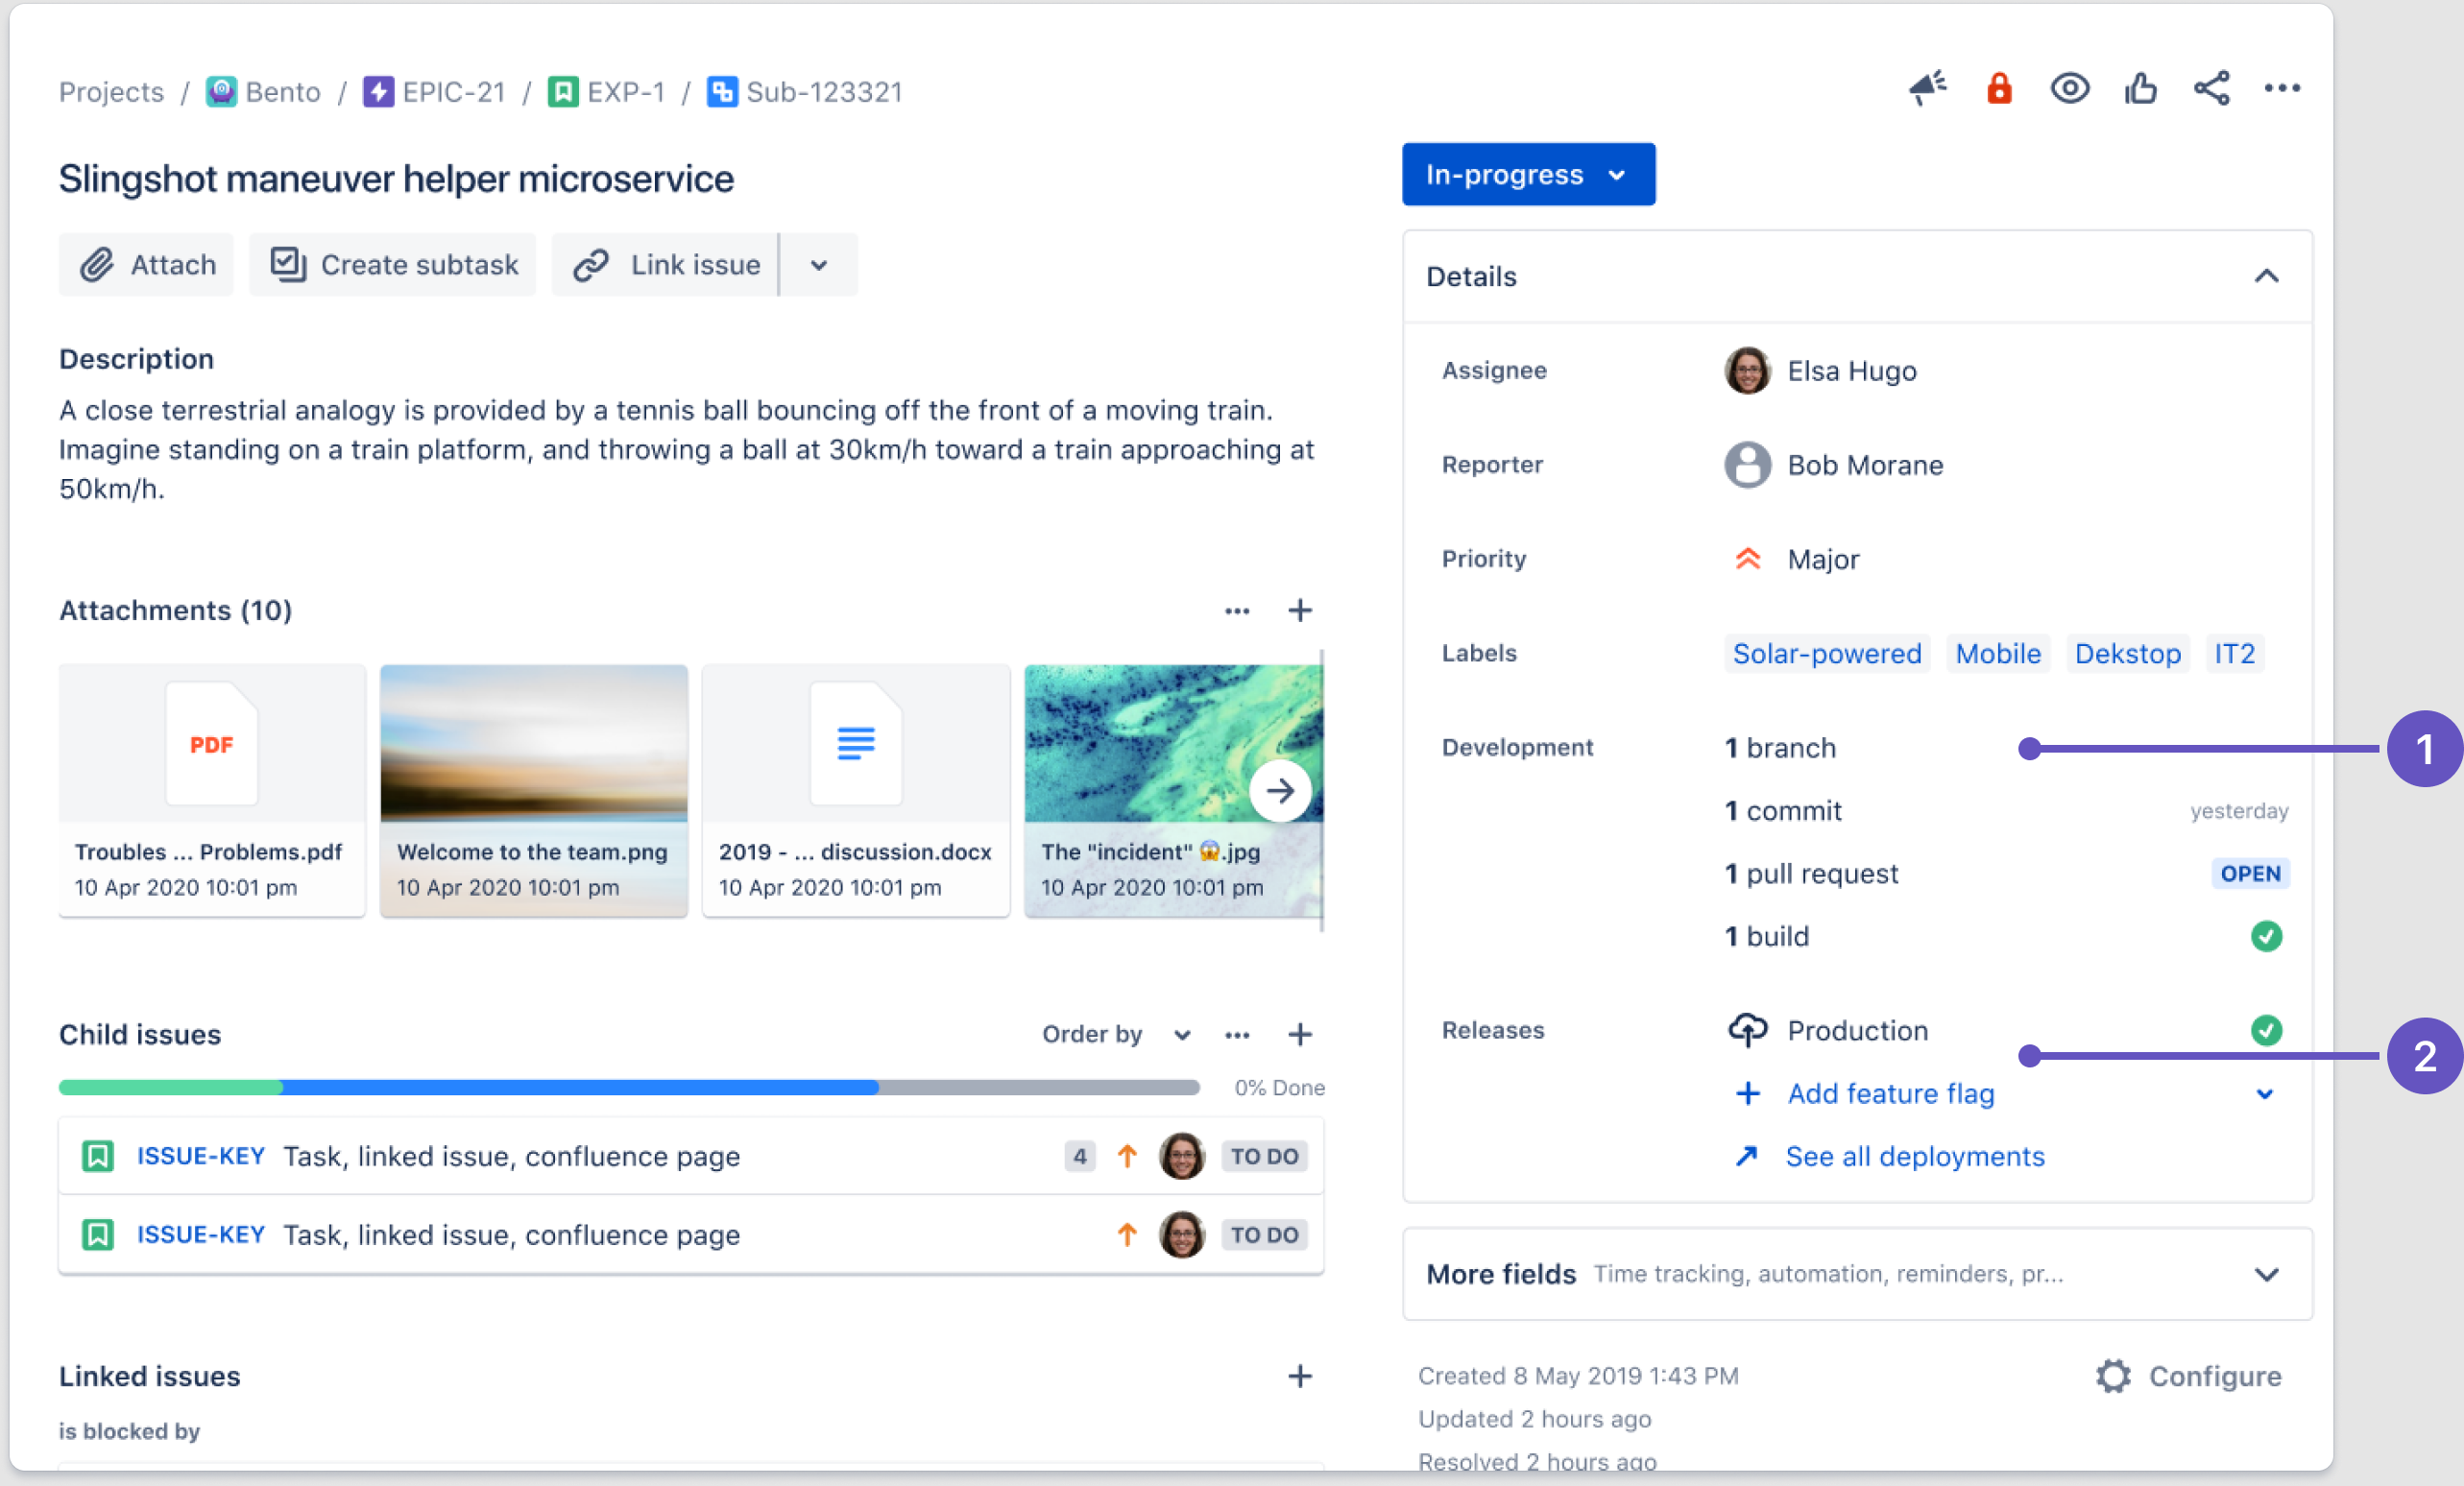
Idée sous-jacente
Le sprint à un objectif unique et très claire
Tous les tickets sont nécessaire pour accomplire l'objectif
Aucun tickets est innutile à l'objectif
Les tickets sont tous ordonnées par priorité
Les tickets n'ont aucune inter-dépendences
sprint tickets
Objectif: Faire site web de vote
| Priority | Title | Point |
|---|---|---|
| 1 | Faire un site web grossier avec deno | 3 |
| 2 | Faire le front-end qui permet de voter | 2 |
| 3 | Permettre à différent utilisateurs de ce logger | 2 |
| 4 | Persister le les votes sur le backend | 2 |
| 5 | deployer en production | 3 |
| 6 | Ajouter une page d'analyse de resultat secrete | 3 |
| 7 | Créer un login pour admin | 2 |
Comment les taches entres et sortes du sprint?
Product Backlog
Le Product Backlog est une liste ordonnée et émergente de ce qui est nécessaire pour améliorer le produit.
C'est l’unique source du travail entrepris par la Scrum Team.
-- scrum guide
Product Backlog
Le product owner est rempli de "user stories" à faire
Les taches ne devrait pas être technique
Product Owner
Le product owner est responsable de parler aux autres équipes (tech ou autres) prendre des requis.
Le product owner est responsable du product backlog
Il se promène d'équipe en équipe pour prendres les requis
Meeting: Sprint Planning
Le product owner arrive avec les choses qui doivent être faites
Les développeur brisent les "user stories" en tickets techniques
Il y a une discussion entre le product owner et la sous équipe technique sur quoi faire (priorité vs facilité)
À la fin du Sprint
Sprint Review
- On assit les clients de l'équipe et on leurs montre ce qui a été fait durant le sprint.
- On prend les feedbacks calmement
- On ouvre de nouvelles user stories
Sprint rétrospection
On lave notre linge sale en famille
On sépare ce qui à fonctionné de ce qui à mal été de ce qui à très mal été
On prépare des actions concrètes pour s'améliorer
Principe solide
C'est quoi SOLID
En programmation orientée objet, SOLID est un acronyme mnémonique qui regroupe cinq principes de conception destinés à produire des architectures logicielles plus compréhensibles, flexibles et maintenables. Les principes sont un sous-ensemble de nombreux principes promus par l'ingénieur logiciel et instructeur américain Robert C. Martin.
-- wikipedia
C'est un accronyme qui représente 5 conceptes
Très axé sur la programmation objet
C'est un moyen de savoir si du code est bon
Mais, ça veut dire quoi?
Responsabilité unique (Single responsibility principle)
Ouvert/fermé (Open/closed principle)
Substitution de Liskov (Liskov substitution principle)
Ségrégation des interfaces (Interface segregation principle)
Inversion des dépendances (Dependency inversion principle)
Responsabilité unique
une classe ne doit changer que pour une seule raison
There should never be more than one reason for a class to change."[5] In other words, every class should have only one responsibility.
-- Robert C. Martin (Uncle bob)
Conséquences
Une class doit être petite
Un objet doit être immutable sauf, au maximum à une seule place
Regardons ce mauvais exemple...
Ouvert/fermé
Principe Ouvert/fermé
une entité applicative (classe, fonction, module ...) doit être fermée à la modification directe mais ouverte à l'extension
Software entities ... should be open for extension, but closed for modification.
-- Robert C. Martin (Uncle bob)
Conséquence
Le plus qu'une classe est utilisé, le plus difficile c'est d'en hériter
Il ne faut jamais changer les arguments d'une méthode hérité
Il faudrait toujours appeler la méthode parente
Une classe qui a des enfants ne peut changer façilement
Regardons ce mauvais exemple...
Principe de substitution de Liskov
Substitution de Liskov
une instance de type T doit pouvoir être remplacée par une instance de type G, tel que G sous-type de T, sans que cela ne modifie la cohérence du programme
Functions that use pointers or references to base classes must be able to use objects of derived classes without knowing it
-- Robert C. Martin (Uncle bob)
En français
Une sous-classe doit être capable d'être utilisé aux même places que la classe parente
Conséquences
Le plus qu'une classe est utilisé, le plus difficile c'est d'en hériter
Le plus qu'une classe à d'enfants, le plus difficile il est de changer la classe
Ségrégation des interfaces
préférer plusieurs interfaces spécifiques pour chaque client plutôt qu'une seule interface générale
Clients should not be forced to depend upon interfaces that they do not use.
-- Robert C. Martin (Uncle bob)
Go proverbs
interface{} says nothing.
The bigger the interface, the weaker the abstraction.
-- rob pike
Rich Hickey
La banane
I think the lack of reusability comes in object-oriented languages, not functional languages. Because the problem with object-oriented languages is they’ve got all this implicit environment that they carry around with them. You wanted a banana but what you got was a gorilla holding the banana and the entire jungle.
-- Joe Armstrong
Conséquence
Une interface devrait être le plus petit possible
En python, les
Inversion des dépendances
il faut dépendre des abstractions, pas des implémentations
-- Robert C. Martin (Uncle bob)
Principe d'inversion des dépendances
Les deux assertions de ce principe sont :
Les modules de haut niveau ne doivent pas dépendre des modules de bas niveau. Les deux doivent dépendre d'abstractions.
Les abstractions ne doivent pas dépendre des détails. Les détails doivent dépendre des abstractions.
Dépendence directe
flowchart TD
    T[Base de donne] --> P1[Load User]
Dépendence avec interface directe
flowchart TD
    T[Base de donne]-- implemente -->I[User Repository Interface]
    P1[Load User]-- utilise -->I
Pour les testes..
- Ajoutons une implementation "in memory"
flowchart TD
    T[Base de donne]-- implemente -->I[User Repository Interface]
    F[In memory db]-- implemente -->I
    P1[Load User]-- utilise -->I
La production peut utiliser la base de donnée
flowchart TD
    Controller --> P[+]
    T[Base de donne] --> P
    P1[Load User] --> P
Les testes peuvent utiliser la base de donnée "in memory"
flowchart TD
    Test --> P[+]
    T[In memory db] --> P
    P1[Load User] --> P
Les testes
C'est quoi un tests?
C'est quoi un test?
En informatique, un test désigne une procédure de vérification partielle d'un système. Son objectif principal est d'identifier un nombre maximal de comportements problématiques du logiciel. Il permet ainsi, dès lors que les problèmes identifiés seront corrigés, d'en augmenter la qualité.
-- wikipedia
Pyramide de tests
Tous les tests ne sont pas égaux
Le plus de choses un test vérifie, le moins le test veut dire quelque chose
Le plus de choses un test vérifie, le plus façile il est à écrire
Monsieur le garagiste, je n'ai pas réussit à aller à l'épicerie avec ma voiture aujourd'hui. Je pense qu'elle est brisé. Pouvez-vous la réparer, si oui, quand sera-t-elle réparée ?
-- didier, la première fois qu'il ira au garagiste
Les différents niveaux de tests
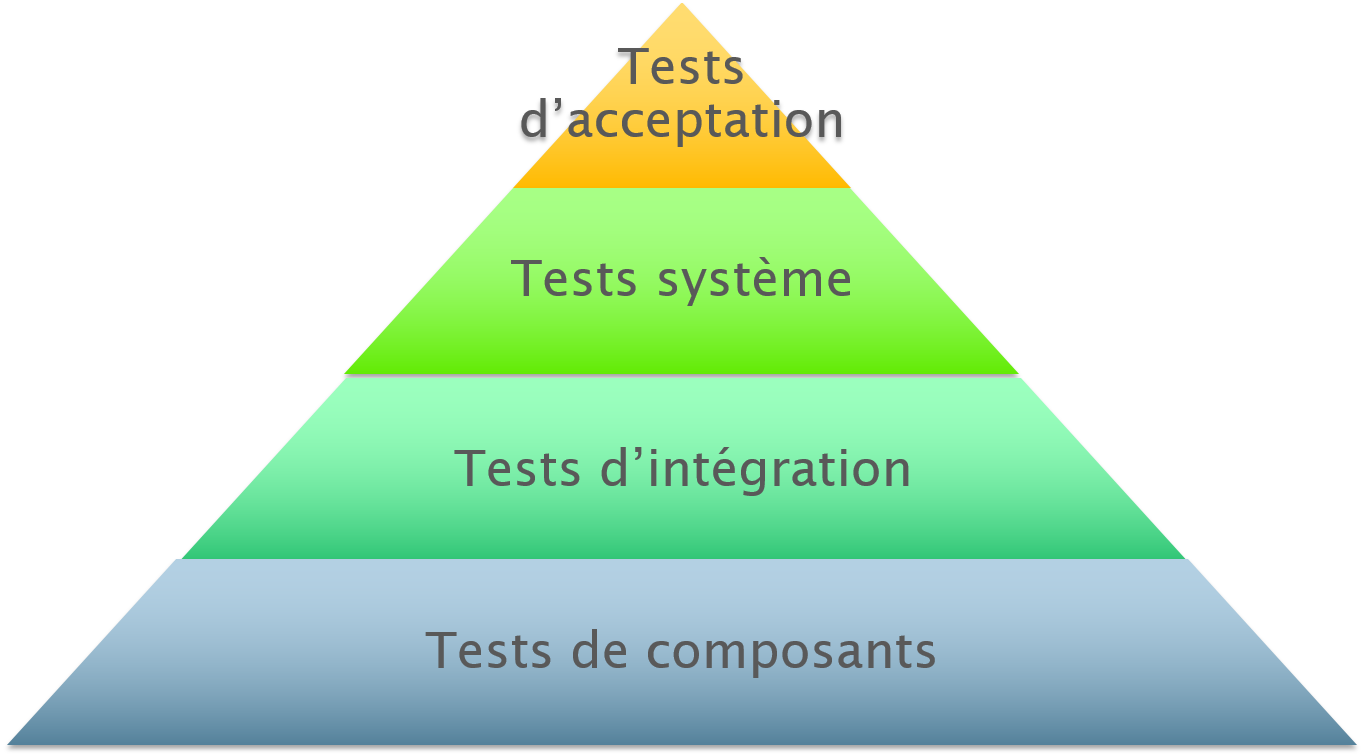
Test d'acceptation (Acceptance testing)
En informatique, le test d'acceptation (ou recette) est une phase de développement des projets, visant à assurer formellement que le produit est conforme aux spécifications (réponse donnée à un instant « t » aux attentes formulées). Elle s'inscrit dans les activités plus générales de qualification.
Executé juste avant de déployer en production
Test plusieurs systèmes
Test très vaste
D'habitude fait par les QAs
Tests système (System testing)
Les tests système de logiciel ou de matériel réfèrent à un processus de test d'un système intégré afin d'évaluer sa conformité aux exigences spécifiées.
Test 1 système de bout-en-bout
Même chose qu'un système d'acceptation mais sur 1 système
D'habitude fait par les QAs
Test d'intégration (Integration testing)
Vérifie le bon fonctionnement d'une partie précise d'un logiciel ou d'une portion d'un programme (appelée « unité » ou « module ») ; dans le test d’intégration, chacun des modules indépendants du logiciel est assemblé et testé dans l’ensemble.
- Test une partie d'un système
- Test avec des "gros" mocks, (aka une base de donnée faite que pour cela)
- Fait par les développeurs
Test de composants (unit testing)
En programmation informatique, le test unitaire est une procédure permettant de vérifier le bon fonctionnement d'une partie précise d'un logiciel ou d'une portion d'un programme (appelée « unité » ou « module »).
- Test une seule fonction sans dépendences sur autre services
- Fait par les développeurs
- Les dieux du test
Comment écire des tests?
Exercice
Écrire un test de la fonction suivante
def is_balanced(text: str) -> bool:
    counter = 0
    for letter in text:
        if letter == "(":
            counter += 1
        if letter == ")":
            counter -= 1
        if counter < 0:
            return False
    return counter == 0
Réponse
def test_is_balances():
    assert is_balanced("")
    assert is_balanced("()")
    assert is_balanced("(()())")
    assert not is_balanced("((())")
    assert not is_balanced("(()))")
    assert not is_balanced(")")
Exercice
Écrire un test de la fonction suivante
def is_balanced_file(file_path: Path) -> bool:
    with open(file_path, "r") as file_:
        text = file_.read()
        counter = 0
        for letter in text:
            if letter == "(":
                counter += 1
            if letter == ")":
                counter -= 1
            if counter < 0:
                return False
        return counter == 0
Note sur la réponse
- La méthode est façile à tester car elle fait une seule chose! Il s'agit du S dans Solid
Réponse, option 1
def write_to_tmp_file(tmp_dir: Path, content: str) -> Path:
    tmp_file = tmp_dir / "foo.txt"
    tmp_file.write_text(content)
    return tmp_dir


def test_is_balanced_file(tmp_path):
    tmp_path = Path(tmp_path)
    assert is_balanced_file(write_to_tmp_file(tmp_path, ""))
    assert is_balanced_file(write_to_tmp_file(tmp_path, "()"))
    assert is_balanced_file(write_to_tmp_file(tmp_path, "(()())"))
    assert not is_balanced_file(write_to_tmp_file(tmp_path, "((())"))
    assert not is_balanced_file(write_to_tmp_file(tmp_path, "(()))"))
    assert not is_balanced_file(write_to_tmp_file(tmp_path, ")"))
Note sur la réponse 1
Ceci est un test d'intégration
Le test dépend de fichiers
- Ça semble peu, mais ça peut être problématique
Réponse, option 2, partie 1
premièrement, on change la fonction
def is_balanced_file_object(file_path: typing.IO[str]) -> bool:
    text = file_path.read()
    counter = 0
    for letter in text:
        if letter == "(":
            counter += 1
        if letter == ")":
            counter -= 1
        if counter < 0:
            return False
    return counter == 0
Réponse, option 2, partie 2
On test avec une version inmemory
def test_is_balanced_file_object() -> None:
    assert is_balanced_file_object(io.StringIO(""))
    assert is_balanced_file_object(io.StringIO("()"))
    assert is_balanced_file_object(io.StringIO("(()())"))
    assert not is_balanced_file_object(io.StringIO("((())"))
    assert not is_balanced_file_object(io.StringIO("(()))"))
    assert not is_balanced_file_object(io.StringIO(")"))
Note sur la réponse 2
- Pour rendre la méthode façile à tester, il faut utiliser la notion d'Inversion des dépendances de SOLID
Réponse, option 3
On change la fonction
is_balanced_filepour utiliser la fonctionis_balancedOn ne test pas la méthodeis_balanced_file
def is_balanced_file(file_path: Path) -> bool:
    with open(file_path, "r") as file_:
        return is_balanced(file_.read())
Note sur la réponse option 3
Le code coverage du résultat sera plus bas
Est-ce vraiment grave? didier pense que non
Exercice
Écrire une fonction qui prend en argument une liste d'entiers
lstet un entiertarget. La fonction doit retourner 2 nombres de lalst(possiblement deux fois le même nombre)aetbtel quea + b = target.Tester la fonction
https://leetcode.com/problems/two-sum/
Exemple
lst = [55, 20, 76, 34, 80, 26]
target = 100
result = (20, 80)
Exercice
Écrire une fonction qui prend un string en paramêtre et qui retourne le plus long "sous-string" qui est un palindrome
Tester la fonction
https://leetcode.com/problems/longest-palindromic-substring/
Exemple
input_ = "la plus belle ville au monde est laval."
result = "laval"
Petit (moyer, ok gros.. ) exercice
En utilisant le module random de python, écrire une fonction qui retoure un mouvement brownien de longeur $n$ et tester le.
Un mouvement brownien est une liste de nombre où le premier item est $0$ et l'item $n+1$ est définit comme la valeur de l'item $n$ plus une valeur aléatoire provenant d'une normale de moyenne 0 et d'écart-type 1.
%pylab inline
from random import Random

def brownian_movement(n, random):
    ret = [1]
    for i in range(n - 1):
        ret.append(ret[-1] + random.gauss(0, 1))
    return ret

plot(list(range(250)), brownian_movement(250, Random(80)))
None
%pylab is deprecated, use %matplotlib inline and import the required libraries.
Populating the interactive namespace from numpy and matplotlib

Pytest: fixtures
Problème explicatif
Écrire une fonction qui prend le nom d'un fichier et qui compte le nombre de ligne dans le fichier
Écrire un teste
# Solution

def count_number_of_line(filename: str) -> int:
    with open(filename, "rt") as file_:
        return file_.read().count("\n")
Pour tester cela
- On va créer un fichier temporaire
- On va écrire un tests
- On va effacer le fichier temporaire
Ce qui se passe avant le test
Ce qui se passe avant un test se nomme souvant "setup", "beforeEach"
Si nous ne sommes pas capable de rouler le "setup", le test doit échouer
Ce qui se passe après le test
Ce qui se passe après le teste se nomme souvant "tearDown", "afterEach"
Il est important que ce qui se passe après le test soit toujours executé!
Pytest - fixtures
Pytest utilise un manière un peu particulière pour gérer les setup & teardown
Chaque setup et teardown est associé à une "chose": la fixture
Le code qui génère une fixture est un "setup"
Le code qui est roulé après une fixture est un "teardown" (avancé)
Utiliser des fixtures
Les arguments des fonctions tests sont des fixtures
Pytest inclue des fixtures https://docs.pytest.org/en/6.2.x/fixture.html
La fixture la plus utile est https://docs.pytest.org/en/6.2.x/reference.html#std-fixture-tmp_path
from pathlib import Path

def test_copy_file(tmp_path: Path) -> None:
    ...
Créer nos fixtures
import pytest

@pytest.fixture
def odd_number() ->:
    return 2 * 25231

def test_is_odd(odd_number) -> None:
    assert is_odd(odd_number)
    assert not is_odd(odd_number + 1)
Créer nos fixtures... suite
- Les fixtures peuvent utiliser d'autres fixtures
import pytest

@pytest.fixture
def odd_number() -> number:
    return 2 * 25231

@pytest.fixture
def even_number(odd_number) -> number:
    return odd_number + 1

def test_is_odd(even_number) -> None:
    assert not is_odd(even_number)
    assert is_odd(even_number - 1)
Exercices - 1
Écrire un programme qui prend le nom d'un fichier JSON personnes et qui retourne le nombre d'homme dans le fichier.
Tester la fonction en utilisant des fixtures
exemple d'input
[
    {"name": "paulette", "sexe": "femme"},
    {"name": "claudette", "sexe": "homme"},
    {"name": "paul", "sexe": "homme"},
    {"name": "herménégilde", "sexe": "homme"},
]
Exercices - 2
Écrire un programme qui prend deux nom de fichiers et qui vérifie si les deux fichiers ont le même contenue
Tester la fonction en utilisant des fixtures
Exercices - 3
Écrire une fonction qui prend un Player et qui ajoute à un fichier une ligne avec la personne sérialisé en format
{prenom} {nom de famille} - {équipe}Tester la fonction en utilisant des fixtures
class Player:
    def __init__(self, first_name, last_name, team):
        self.first_name = fist_name
        self.last_name = last_name
        self.team = team


def serialize_player_to_file(player: Player, filename: Path) -> None:
    pass
Mocks
Des fois, nous ne sommes pas capable d'isoler nos functions
La fonction ne fait que du input/output
La fonction dépend de libraries merdiques
Il serait compliquer de tout découpler
Exercices
Écrire une fonction qui prend en argument un url ainsi qu'un nom de fichier et qui télécharge l'url dans le fichier.
Tester la fonction
truc
utiliser l'url https://httpbin.org/get
utiliser la librarie requests
il n'y a pas de trucs ici, il faut faire du IO :(
Que pouvons nous faire dans cette situation là?
Utilisé du IO mais très restraint (pas toujours possible)
Mocker
Python mock
Python possède une des meilleur libraries pour faire des mocks
TDD
Écrire des tests est difficile
On a vue qu'écrire des tests est difficile.
Les fonctions doivent faire une et une unique chose
Les fonctions doivent utiliser la notion la notion d'Inversion des dépendances
Est-ce que nous pouvons nous faciliter la vie?
Oui! En écrivant les tests avant d'écrire le code.
Test Driven Development
Développé par Kent Beck
Provien du début des années 2000
Est un accronyme vraiment important à ajouter à votre CV
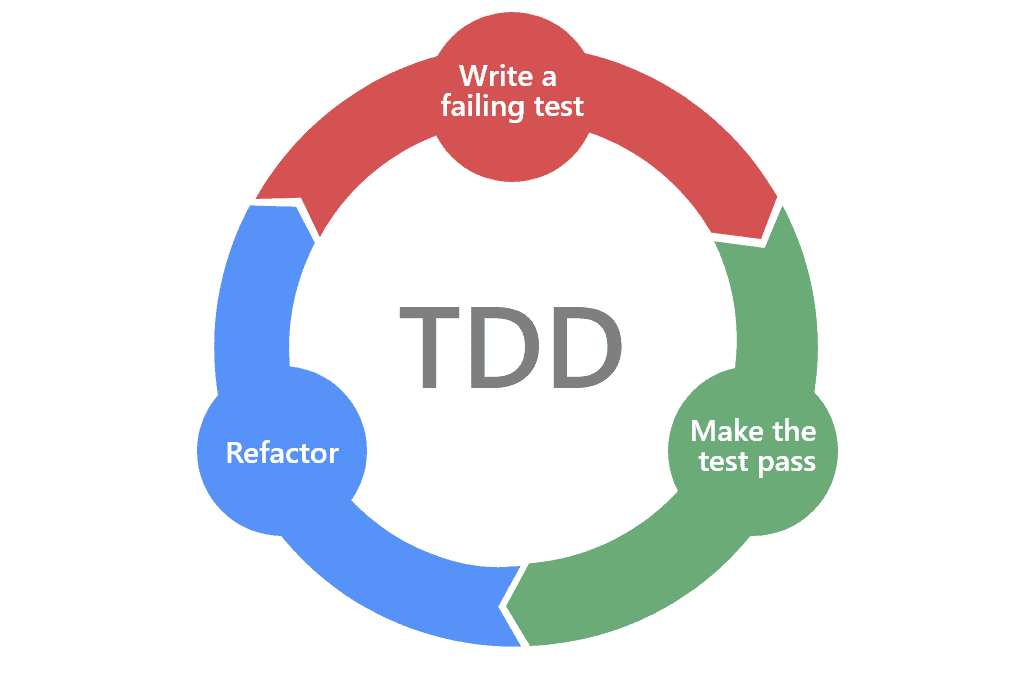
Les 3 phases du TDD
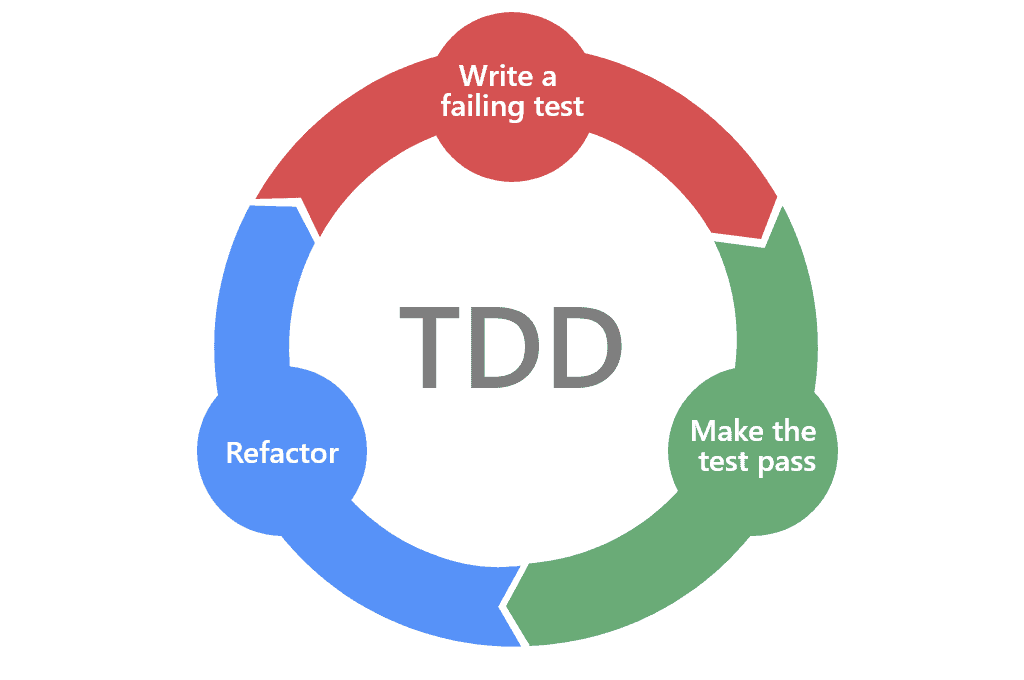
Pourquoi TDD
Nous allons avoir un ensemble de test qui vérifie parfaitement le logiciel
Le code sera testable dès le jour 1
Le project sera toujour à 15 minutes d'être près pour la production
Nous allons avoir des exemples de chanques fonction dans le code
Nous allons utiliser très peu de mocks
Les tests seront aussi beau que le code de base
Références
Test-Driven Development
Le problème
Nous savons que
Il faut écrire des testes
Les programmeurs doivent écrirent des tests
Tests unitaires
Tests d'intégrations
Problème: comment ça devrait se passer en pratique?
Quand devons nous écrire des tests
Quelle devrait être la porté des tests
Solution: Test-Driven Development
- Abbreviation: TDD
C'est quoi le Test-Driven Development (TDD)
Le Test-Driven Development
C'est une méthode d'écritude de programme
C'est pratiquement spirituel
Ça ne dépend pas de libraries où de paradigmes
Comment Écrire du code manière TDD?
Exemple - Kata
Écrire un programme qui...
Compte le pointage au bowling!
Exercices - Kata
Référence
Mocks
Des fois, nous ne sommes pas capable d'isoler nos functions
La fonction ne fait que du input/output
La fonction dépend de libraries merdiques
Il serait compliquer de tout découpler
Exercices
Écrire une fonction qui prend en argument un url ainsi qu'un nom de fichier et qui télécharge l'url dans le fichier.
Tester la fonction
truc
utiliser l'url https://httpbin.org/get
utiliser la librarie requests
il n'y a pas de trucs ici, il faut faire du IO :(
import requests
from pathlib import Path
from shutil import copyfileobj

def download_to_file(url: str, dest: Path) -> None:
    with requests.get(url, stream=True) as resp:
        resp.raise_for_status()
        with open(dest, 'wb') as file_:
        copyfileobj(resp.raw, file_)


download_to_file("https://httpbin.org/get", Path("/") / "tmp" / "foo")
---------------------------------------------------------------------------
AttributeError                            Traceback (most recent call last)
Cell In[8], line 10
      6         resp.raise_for_status()
      7         print(resp.file)
---> 10 download_to_file("https://httpbin.org/get", Path("/") / "tmp" / "foo")

Cell In[8], line 7, in download_to_file(url, file_)
      5 with requests.get(url, stream=True) as resp:
      6     resp.raise_for_status()
----> 7     print(resp.file)

AttributeError: 'Response' object has no attribute 'file'
Que pouvons nous faire dans cette situation là?
Utilisé du IO mais très restraint (pas toujours possible)
Mocker
Python mock
Python possède une des meilleur libraries pour faire des mocks